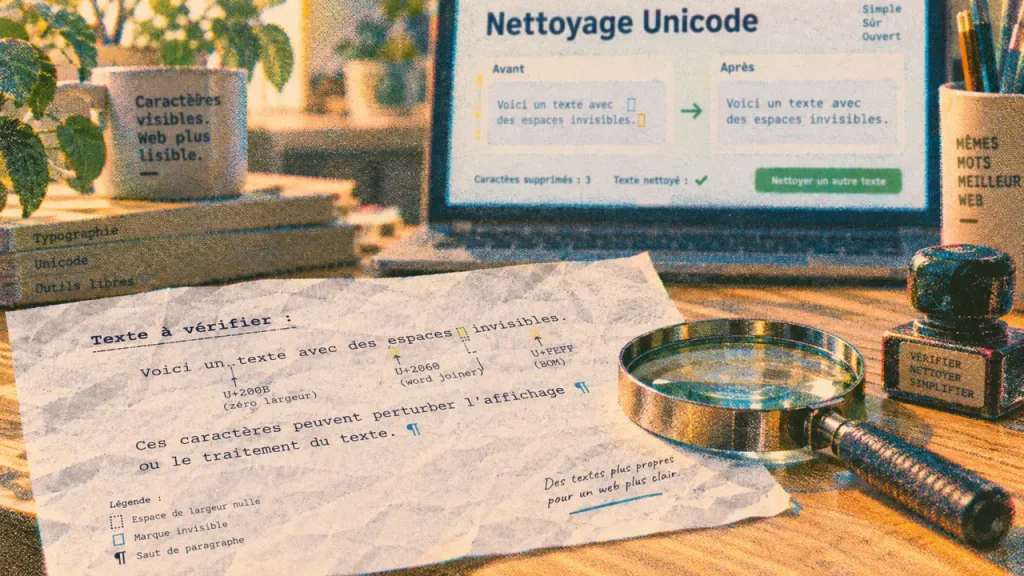
Pour retirer un filigrane ChatGPT supposé, commencez par identifier ce qui peut réellement être nettoyé : caractères invisibles, espaces atypiques ou marqueurs Unicode présents après un copier-coller. Un outil adapté analyse le texte, affiche les éléments détectés, les supprime sans modifier les phrases visibles, puis permet de récupérer une version propre. Cette opération peut être utile avant une publication, un import dans un CMS, l’envoi d’un document ou l’intégration d’un texte dans du code.
Ce qu’un « filigrane ChatGPT » peut réellement désigner
Le terme filigrane ChatGPT recouvre plusieurs réalités qu’il faut distinguer. Certains utilisateurs parlent de filigrane lorsqu’un texte contient des caractères non imprimables. À l’écran, le contenu semble normal, mais une recherche exacte, un copier-coller ou une comparaison de chaînes produit un résultat inattendu. D’autres évoquent un éventuel signal statistique lié à la génération par un modèle de langage. Ces deux sujets ne reposent pas sur les mêmes mécanismes.
Les caractères invisibles sont détectables dans le texte
Des caractères Unicode cachés peuvent apparaître après un copier-coller depuis une application, une page web ou un document. Parmi les plus connus figurent l’espace de largeur nulle U+200B, le Zero Width Non-Joiner U+200C, le Zero Width Joiner U+200D, le Word Joiner U+2060, le marqueur U+FEFF, aussi appelé Zero Width No-Break Space ou BOM, ainsi que le tiret conditionnel U+00AD. Un scanner Unicode peut les identifier et compter leurs occurrences.
La présence de ces caractères ne prouve pas, à elle seule, qu’un filigrane a été ajouté par ChatGPT. Ils peuvent provenir d’un éditeur, d’un format de fichier, d’un navigateur ou d’une succession de collages. Leur présence reste toutefois vérifiable. Les supprimer peut résoudre des problèmes de recherche, de comparaison ou de mise en forme.
Un signal statistique ne se retire pas avec un nettoyeur Unicode
Un filigranage statistique, s’il est utilisé par un système de génération, reposerait sur des choix de mots ou de tokens plutôt que sur un caractère caché placé entre deux lettres. Un outil qui supprime U+200B ou U+FEFF ne modifie donc pas ce type de signal hypothétique. Il ne transforme pas non plus automatiquement un texte en contenu « humain » et ne garantit aucun résultat face à Turnitin, GPTZero ou d’autres détecteurs IA. Ces services peuvent analyser le style, la structure ou des probabilités linguistiques.
Retirer les caractères invisibles en conservant le texte visible
La méthode la plus sûre consiste à utiliser un outil qui sépare l’analyse du traitement. Vous devez pouvoir vérifier ce qui a été détecté avant de supprimer quoi que ce soit, surtout si le document contient plusieurs langues, des URL, du code ou une mise en forme importante.
- Copiez le texte dans la zone d’analyse ou importez le document si l’outil accepte ce format.
- Lancez un diagnostic pour afficher les caractères invisibles, les espaces inhabituels, les tabulations et, si nécessaire, les tirets cadratins.
- Contrôlez la liste des codes détectés et leur nombre d’occurrences. Un aperçu avant/après permet de repérer une suppression inattendue.
- Choisissez l’action : supprimer les marqueurs, normaliser les espaces ou remplacer certains signes de ponctuation.
- Relisez et exportez le résultat dans le format adapté à votre usage.
Pour un texte courant, supprimer les caractères de largeur nulle et certains marqueurs de contrôle est généralement approprié. La suppression systématique ne convient toutefois pas à tous les contenus. Les joncteurs peuvent avoir une fonction légitime dans certaines écritures, notamment en arabe ou en persan. Dans ce cas, choisissez une suppression sélective ou travaillez sur une copie du document original.
Un texte nettoyé circule plus facilement entre un e-mail, une feuille de calcul, un formulaire, un CMS ou une base de données. Ce bénéfice dépasse l’aspect visuel. Une référence produit, un identifiant ou une adresse URL peut sembler identique à l’œil, tout en devenant introuvable ou impossible à dédupliquer si une chaîne contient un caractère de largeur nulle.
Les problèmes résolus par un nettoyage Unicode
Retirer les caractères cachés ne sert pas uniquement à s’interroger sur l’origine d’un texte. L’objectif principal est d’améliorer la fiabilité du contenu lorsqu’il passe d’un outil à l’autre.
| Situation | Effet possible des caractères invisibles | Action recommandée |
|---|---|---|
| Recherche exacte dans un document | Un mot apparemment identique ne remonte pas dans les résultats. | Supprimer les espaces de largeur nulle et normaliser le texte. |
| CMS, e-mail ou formulaire | Espacements irréguliers, lignes cassées ou validation imprévisible. | Nettoyer avant le collage définitif. |
| Code, JSON, URL ou identifiants | Erreur difficile à repérer, URL invalide ou comparaison de chaînes échouée. | Utiliser un mode prudent et vérifier chaque suppression. |
| Diff Git et linter | Modifications artificielles ou alerte sur un caractère non imprimable. | Afficher les caractères de contrôle avant de valider. |
| Document mis en page | Retours à la ligne, justification ou nombre de caractères faussés. | Comparer la version nettoyée et la version originale. |
Faut-il aussi supprimer les tirets cadratins ?
Les tirets cadratins ne sont pas invisibles et ne constituent pas un filigrane. Ils sont parfois ciblés parce qu’ils donnent une apparence typographique particulière ou posent problème dans certains champs de saisie. Leur remplacement par un tiret simple, un tiret demi-cadratin ou une virgule relève d’un choix éditorial, pas d’un nettoyage de sécurité.
Conservez-les si leur usage sert le rythme et la lisibilité du texte. Remplacez-les uniquement pour respecter une charte, une contrainte de saisie ou un format technique. Cette opération modifie le texte visible, contrairement à la suppression d’un caractère Unicode caché.
Nettoyage, humanisation et paraphrase : trois opérations distinctes
Les outils présentés comme des solutions de suppression de filigrane IA mélangent parfois des fonctions qui n’ont pas le même effet. Pour choisir la bonne méthode, partez de votre objectif : corriger une chaîne, adapter un ton ou retravailler un contenu.
- Nettoyage Unicode : il retire ou normalise des caractères cachés. Les mots et le sens restent identiques.
- Normalisation typographique : elle harmonise les espaces, les guillemets, les retours à la ligne ou la ponctuation selon des règles définies.
- Paraphrase : elle reformule le texte visible. Le vocabulaire, la longueur et parfois la nuance changent.
- Humanisation : elle promet généralement une réécriture plus naturelle. La prose est donc modifiée et doit être relue attentivement.
Si vous souhaitez uniquement retirer un filigrane ChatGPT assimilé à des caractères cachés, le nettoyage Unicode suffit. N’utilisez pas un paraphraseur pour résoudre un problème de copier-coller : vous pourriez altérer des faits, des citations, des termes juridiques, du code ou une voix éditoriale déjà validée. À l’inverse, nettoyer un texte ne remplace pas une relecture lorsque l’objectif est d’améliorer la clarté, la précision ou l’originalité de l’écriture.
Le nettoyage ne garantit pas non plus l’absence de détection par un outil qui évalue le style ou les probabilités linguistiques. Supprimer un marqueur invisible et réécrire un contenu sont deux interventions différentes, avec des effets différents sur le document.
Confidentialité, formats et contrôles avant l’export
Avant de coller un contenu sensible dans un service en ligne, vérifiez où le traitement est effectué. Un traitement local dans le navigateur peut limiter la transmission du texte, mais cette caractéristique doit être clairement expliquée par l’outil choisi. Si le service traite les documents sur un serveur, consultez sa politique de conservation : durée de stockage, suppression des fichiers, journalisation et accès éventuel aux données.
Les outils n’acceptent pas tous les mêmes formats. Le texte brut est le plus simple à nettoyer. Pour les documents DOCX ou Apple Pages, contrôlez la conservation des titres, des listes, des tableaux, des commentaires et des liens après l’export. Un PDF doit souvent être converti ou son texte extrait, ce qui peut déjà modifier la mise en page. Dans Google Docs ou un CMS, un collage dans un éditeur sans mise en forme avant publication peut aussi aider à repérer les anomalies.
Les fonctions disponibles varient également selon l’outil : import de fichiers, compteur de caractères, affichage des espaces et tabulations, comparaison avant/après ou export du résultat. Vérifiez les limites annoncées avant de traiter un document volumineux. Une limite de 15 000 caractères ou de 50 Mo, par exemple, peut déterminer la méthode à utiliser, mais ces valeurs dépendent du service concerné.
Enfin, conservez toujours l’original et effectuez trois vérifications : comparez le nombre de caractères, recherchez les termes clés et testez les éléments sensibles comme les URL, les références ou les extraits de code. Le nettoyage est une opération technique utile. Il ne dispense ni de respecter les règles d’attribution applicables aux contenus générés par IA, ni de relire le document avant de le publier ou de le remettre.